
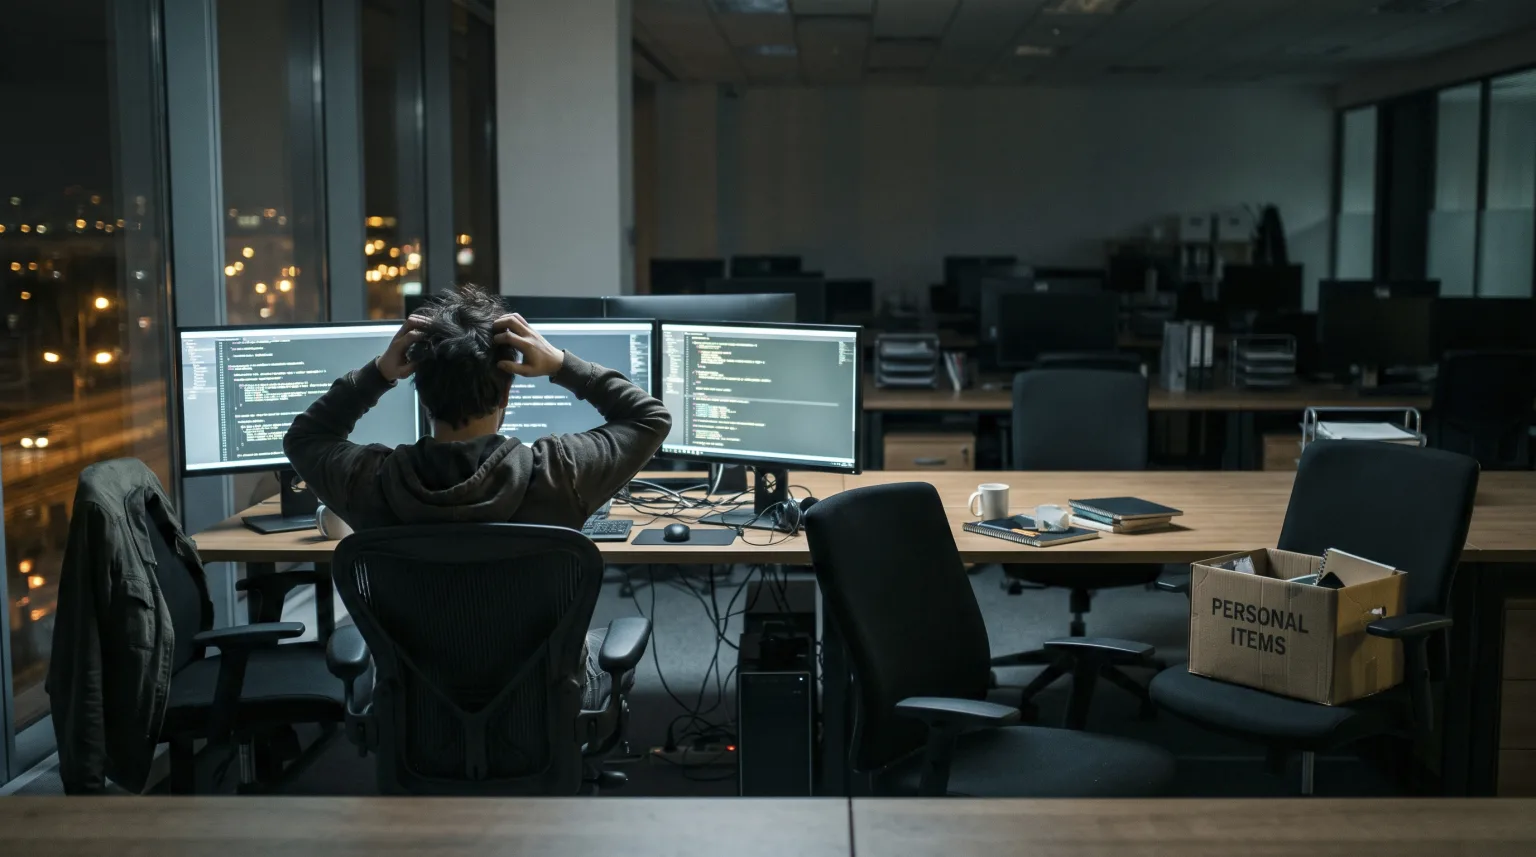
Un développeur s’installe devant son écran, ouvre un forum et commence à écrire. Il ne donne ni son nom ni celui de son employeur. En quelques paragraphes, il raconte une année entière de sa vie professionnelle. Son message, publié sur Reddit puis repris sur Lemmy, a depuis été relayé en France sous un titre qui ne laisse aucune place au doute : un labyrinthe opaque (Developpez.com).
Le récit commence comme une success story. Il y a un an, la direction annonce que tout le développement passera désormais par des agents d’IA. Écrire du code à la main devient l’exception, et l’exception doit être justifiée. Pendant six mois, l’équipe vit une forme d’euphorie : elle livre plus qu’elle n’a jamais livré (Lemmy).
Puis le décor change. La base de code a environ triplé. Plus personne ne sait expliquer comment la majeure partie fonctionne. Les agents eux-mêmes s’y perdent : ils réécrivent des fonctions utilitaires qui existent déjà ailleurs, parce qu’il existe désormais quatre versions de tout (Lemmy).
Je vous dois une précision avant d’aller plus loin. Ce témoignage est anonyme. Personne ne peut vérifier le nom de l’entreprise ou le chiffre du triplement. Je le traite donc pour ce qu’il est : le récit d’une seule personne, avec ses biais. Il mérite pourtant votre attention, parce que chacun des symptômes qu’il décrit a été mesuré ailleurs, par des chercheurs qui publient leurs méthodes et leurs données.
Six mois d’euphorie, puis l’addition
Commençons par l’euphorie. Elle a une explication, et elle est mesurable.
En 2025, l’organisme de recherche METR a mené un essai contrôlé randomisé auprès de 16 développeurs expérimentés. Ils ont traité 246 tâches réelles sur des projets open source qu’ils connaissaient depuis des années, des bases de code dépassant souvent le million de lignes. Chaque tâche était tirée au sort : avec ou sans IA. Avant l’expérience, les développeurs prévoyaient de gagner 24 % de temps. Après l’expérience, ils estimaient avoir gagné 20 %. Le chronomètre disait autre chose : avec l’IA, ils avaient mis 19 % de temps en plus (METR).
Relisez ces trois chiffres. Des professionnels aguerris, sur leur propre code, se sentaient plus rapides alors qu’ils étaient plus lents. Le ressenti et la mesure partaient dans des directions opposées.
Les auteurs de l’étude restent prudents, et j’apprécie cette prudence : leurs résultats portent sur un contexte précis et ne prouvent pas que l’IA ralentit tout le monde, partout. Mais ils montrent une chose qu’aucun dirigeant ne devrait ignorer. L’impression de vitesse reste une hypothèse tant qu’on ne l’a pas mesurée. Et les hypothèses doivent être tuées par l’expérimentation le plus tôt possible.
L’équipe du témoignage a vécu exactement ce décalage. Elle a mesuré ce qui était facile à mesurer, le volume livré, et elle a pris ce volume pour de la valeur.
Le deuxième symptôme, le code qui enfle et se répète, a lui aussi été mesuré. La société GitClear a analysé 211 millions de lignes de code modifiées entre 2020 et 2024. En 2024, la fréquence des blocs de cinq lignes ou plus dupliqués a été multipliée par huit. La même année, pour la première fois, le code copié-collé a dépassé le code déplacé, c’est-à-dire le code réorganisé pour être réutilisé (GitClear).
Traduisez ce résultat dans la langue d’un comité de direction : votre logiciel grossit plus vite qu’il ne s’organise. Chaque duplication est un endroit de plus où une correction devra être appliquée, et un endroit de plus où on l’oubliera. Les « quatre versions de tout » du témoignage ressemblent à ce que GitClear observe à grande échelle.
Un programme vit dans la tête de ceux qui l’ont construit
Pour comprendre pourquoi personne ne sait plus expliquer ce code, il faut remonter à 1985. Cette année-là, Peter Naur, lauréat du prix Turing et coauteur de la notation BNF, publie un court essai intitulé « Programming as Theory Building ». Sa thèse dérange encore aujourd’hui (Peter Naur).
Pour Naur, programmer consiste d’abord à construire une théorie : une compréhension du problème et des raisons de chaque choix. Le code n’est qu’une trace partielle de cette théorie. La théorie, elle, vit dans la tête des personnes qui ont construit le programme. Naur va plus loin. Selon lui, reconstruire la théorie d’un programme à partir de sa seule documentation est strictement impossible. Un programme meurt quand l’équipe qui en possède la théorie se disperse, et sa mort devient visible le jour où plus personne ne peut répondre intelligemment à une demande de modification (Peter Naur).
Relisez le témoignage avec cette grille. Pendant un an, l’entreprise a produit du code sans que personne ne construise la théorie correspondante. L’agent génère, le test passe. Personne n’a eu à comprendre. Le code existe, la théorie n’existe nulle part.
Tout CTO connaît ce moment où l’architecte qui portait un système dans sa tête quitte l’entreprise. J’ai dirigé plus de 1 100 ingénieurs, et ce départ fait partie des risques qu’on surveille. Ici, la situation est plus inquiétante encore. Personne n’est parti avec la théorie, parce qu’elle n’a jamais été construite.
Le départ des deux relecteurs, le signal que personne n’a vu
Un détail du témoignage m’a frappé plus que le triplement de la base de code. Les deux personnes qui lisaient chaque modification et osaient s’y opposer sont parties au printemps. L’une a démissionné. L’autre a été « restructurée », selon l’euphémisme désormais consacré (Lemmy).
Un outil de revue automatique commente toujours chaque modification. Mais il ne reste plus personne capable de dire si un commentaire compte. Alors l’équipe marque tous les commentaires comme résolus, sans les lire. Et l’auteur ajoute une phrase qui devrait empêcher de dormir n’importe quel directeur technique : la moitié de l’équipe n’a rien écrit de non trivial depuis un an, et ça se voit (Lemmy).
Ce passage décrit une question de culture bien plus qu’une question de technologie. Ces deux relecteurs étaient l’esprit critique de l’organisation. Ils incarnaient la possibilité de dire « je ne comprends pas » et « ça ne va pas ». Sans sécurité psychologique, personne n’ose remettre en question le statu quo, ni avouer qu’il ne comprend plus ce qu’il valide. Le sentiment d’être en sécurité pour ne pas avoir à cacher des résultats décevants fait partie des conditions qui permettent à une équipe d’apprendre (Mon livre, chapitre 9).
Posez-vous la question honnêtement. Dans votre organisation, un développeur peut-il dire en réunion « ce module, je ne sais plus l’expliquer » sans craindre pour son poste ? Si la réponse est non, votre labyrinthe est peut-être déjà en construction. Vous ne le verrez simplement pas avant qu’il soit trop tard.
Le code « presque juste » coûte cher
On pourrait objecter que tout cela relève du confort des développeurs. Le code tourne, les clients sont servis, où est le problème ? Il est dans ce que personne ne regarde.
En juillet 2025, Veracode a publié une étude portant sur 80 tâches de programmation confiées à plus de 100 grands modèles de langage. Dans 45 % des cas, le code produit introduisait une faille de sécurité figurant dans le Top 10 de l’OWASP, la liste de référence des risques les plus critiques pour les applications web. En Java, le taux d’échec dépassait 70 %. Et la performance en sécurité ne s’améliorait pas avec les modèles plus récents (Veracode).
Les développeurs le savent. L’enquête annuelle de Stack Overflow, menée auprès de plus de 48 000 répondants en 2025, montre que 84 % d’entre eux utilisent ou prévoient d’utiliser des outils d’IA. Pourtant, 46 % disent ne pas faire confiance à l’exactitude de leurs résultats, contre 31 % un an plus tôt. Leur première frustration, citée par 66 % d’entre eux : des solutions « presque justes, mais pas tout à fait » (TechRepublic).
Combinez ces données avec le témoignage. Un code dont 45 % des échantillons testés par Veracode contenaient une faille, que les développeurs eux-mêmes jugent souvent « presque juste », validé par une équipe qui ne sait plus l’expliquer et qui a cessé de lire les alertes. Le sujet dépasse largement la productivité : un risque d’entreprise grandit en silence.
La métrique que votre tableau de bord ne montre pas
Ne vous méprenez pas sur mon propos. Je ne vous demande pas de bannir l’IA du développement logiciel. Ce serait absurde, et vos concurrents ne vous attendront pas. Dès la cohorte de l’hiver 2025 de Y Combinator, un quart des startups avaient une base de code générée à 95 % par l’IA. L’un des associés de l’accélérateur ajoutait qu’une compétence resterait indispensable aux fondateurs : savoir lire le code et y trouver les bugs (TechCrunch).
Tout est là. L’erreur de l’entreprise du témoignage tient à sa façon de piloter le changement. Elle a imposé un pourcentage, 100 %, au lieu de fixer un objectif. Elle a mesuré le volume au lieu de la compréhension. Et elle a laissé partir les personnes qui gardaient la théorie du système.
Dans ma méthode d’adoption de l’IA, l’équipe d’exploration doit se poser deux questions pour chaque usage. Comment l’IA peut-elle augmenter ma productivité et la qualité de ce que je délivre ? Que puis-je faire maintenant grâce à l’IA qui était impossible auparavant ? Tout usage de l’IA qui ne répond pas à l’une de ces deux questions est une distraction. Et pour vérifier que les gains espérés sont réels, il faut mesurer avant, pendant et après (Mon livre, chapitre 14).
Appliquée au code, cette discipline donne des règles simples :
- Pour chaque module critique, nommez au moins une personne capable de l’expliquer et de le modifier en confiance. Si personne ne remplit ce rôle, vous avez trouvé votre zone de risque.
- Avant toute fusion de code généré, demandez à son auteur d’expliquer avec ses propres mots ce que fait le code et pourquoi. S’il ne peut pas, le code n’est pas prêt.
- Gardez des humains sur les parties non triviales. Une compétence qu’on n’exerce plus s’atrophie, et le témoignage le montre.
- Mesurez la duplication et les failles en plus du volume livré.
Rien de tout cela n’interdit l’IA. Ces règles empêchent seulement l’IA de produire une base de code sans propriétaire.
L’essentiel
Retenez quatre choses :
- L’impression d’aller plus vite reste une hypothèse à vérifier. Dans l’étude METR, des développeurs expérimentés se croyaient 20 % plus rapides alors qu’ils étaient 19 % plus lents.
- Un programme vit dans la tête de ceux qui le comprennent. Du code que personne n’a compris est un programme sans théorie, donc sans avenir.
- Les relecteurs qui disent non sont un actif. Quand ils partent, votre organisation perd sa capacité à voir ses propres erreurs.
- Fixez des objectifs de compréhension. Un pourcentage de code généré ne dit rien de la valeur produite. Nommez un humain responsable de chaque module critique.
Pour sortir du labyrinthe, l’entreprise du témoignage devra reconstruire la théorie de son propre logiciel. Cela demandera du temps et l’humilité d’admettre que la vitesse ressentie était une illusion. Une entreprise qui n’innove pas est déjà morte. Une entreprise qui confond volume et innovation risque de l’apprendre plus tard que les autres. Innover ou agoniser, c’est vous qui voyez !
Références
- (Mon livre) https://philippeboulanger.com/fr/livre/
- (Developpez.com) https://intelligence-artificielle.developpez.com/actu/388924/Un-an-apres-avoir-decide-de-generer-100-pourcent-de-son-code-source-avec-l-IA-une-entreprise-se-retrouve-face-a-un-labyrinthe-opaque-personne-ne-peut-expliquer-comment-la-majeure-partie-fonctionne/
- (Lemmy) https://lemmy.world/post/54218172
- (METR) https://arxiv.org/abs/2507.09089
- (GitClear) https://www.gitclear.com/ai_assistant_code_quality_2025_research
- (Peter Naur) https://pages.cs.wisc.edu/~remzi/Naur.pdf
- (Veracode) https://www.veracode.com/press-release/ai-generated-code-poses-major-security-risks-in-nearly-half-of-all-development-tasks-veracode-research-reveals/
- (TechRepublic) https://www.techrepublic.com/article/news-developer-trust-in-ai-declines/
- (TechCrunch) https://techcrunch.com/2025/03/06/a-quarter-of-startups-in-ycs-current-cohort-have-codebases-that-are-almost-entirely-ai-generated/