
On applaudit les copies parfaites. Puis le réel arrive.
On nous vend des IA comme on vendait autrefois les élèves modèles.
Elles réussissent les examens.
Elles impressionnent sur les benchmarks.
Elles récitent avec fluidité.
Elles répondent vite.
Elles produisent un texte propre, carré, rassurant.
Le spectacle est efficace.
Depuis des mois, le marché se gave de démonstrations où les modèles brillent sur des tests scolaires, professionnels ou académiques. OpenAI a largement popularisé cette narration en expliquant que GPT-4 pouvait réussir un barreau simulé autour du top 10 % des candidats (OpenAI). Le message implicite était limpide : si la machine écrase l’examen, elle doit être en train de rattraper, puis dépasser, l’intelligence humaine.
Puis arrive ARC-AGI-3.
Et soudain, la mise en scène se dérègle.
ARC-AGI-3 ne demande pas de réciter. Il demande de comprendre.
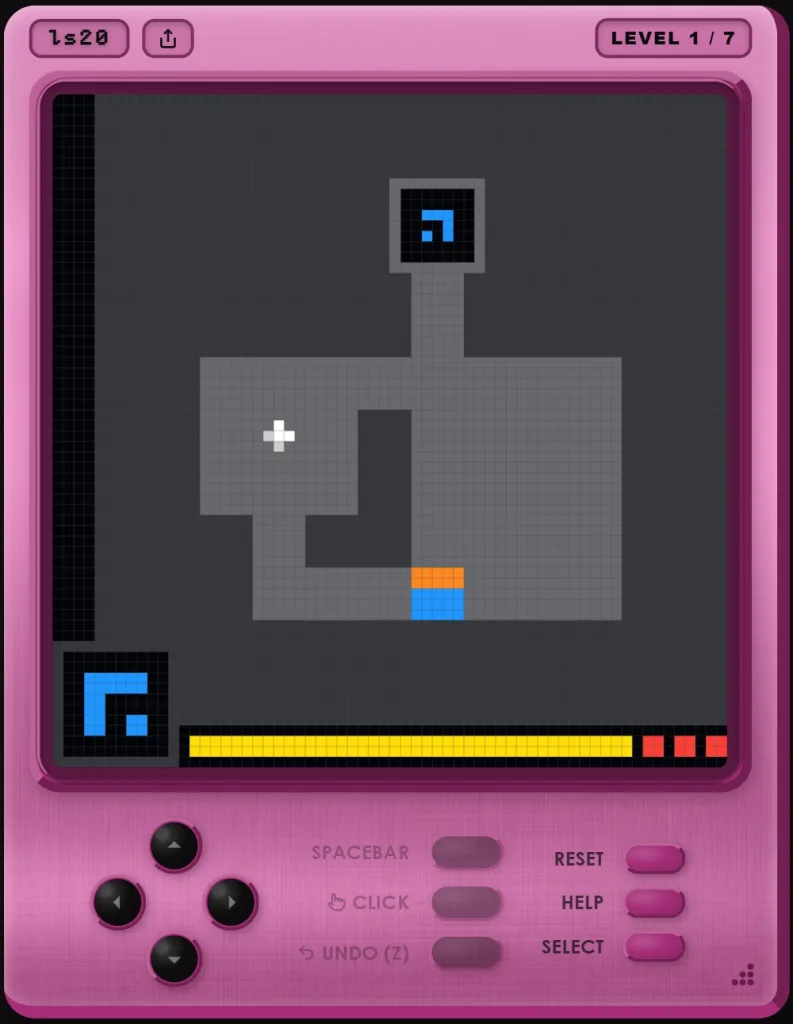
ARC-AGI-3 n’est pas un benchmark de plus posé sur une étagère déjà encombrée. C’est un test interactif conçu pour mesurer une forme de raisonnement plus proche de l’adaptation réelle à un environnement inconnu. Le benchmark repose sur des centaines d’environnements originaux, sous forme de jeux au tour par tour, sans notice, sans règles explicites, sans objectif annoncé. L’agent doit explorer, inférer ce qui compte, comprendre ce qui marche, puis réutiliser ce qu’il apprend à mesure que les niveaux montent en difficulté (ARC Prize, ARC Prize, arXiv).
C’est là que l’écart devient fascinant.
ARC Prize annonce une performance humaine à 100 %, tandis que les systèmes de pointe restent sous 1 %. La publication de lancement résume même l’écart par une formule brutale : “Humans score 100%. Frontier AI scores 0.26%.” Le leaderboard public confirme que nous sommes encore à des niveaux minuscules sur cette nouvelle famille d’épreuves (ARC Prize, ARC Prize, ARC Prize).
Autrement dit : la machine qui peut vous sortir une copie brillante sur un examen codifié peut aussi se retrouver totalement perdue dès qu’il faut explorer un monde nouveau sans béquille explicative.
Cliquez sur l’image ci-dessous ou ici pour jouer au jeu qui met les IA en difficulté.
Le problème des entreprises n’est pas technique. Il est conceptuel.
Beaucoup d’équipes regardent encore l’IA avec des lunettes trop anciennes.
Elles voient une réponse propre.
Elles en déduisent une compréhension.
Elles voient une bonne note.
Elles en déduisent du jugement.
Elles voient de la fluidité.
Elles en déduisent de l’autonomie stratégique.
C’est une erreur de catégorie.
Réussir un cadre connu n’est pas équivalent à apprendre dans l’inconnu.
Compresser des montagnes de données n’est pas équivalent à construire un modèle du monde.
Produire une sortie convaincante n’est pas équivalent à comprendre la situation qui vient d’émerger.
ARC-AGI-3 remet une hiérarchie saine dans le débat : l’intelligence qui compte le plus dans les environnements mouvants n’est pas la restitution, c’est l’adaptation. Le papier technique insiste précisément sur l’exploration, l’inférence des buts, la construction de modèles internes de l’environnement et la planification d’actions efficaces sans instructions explicites (arXiv).
Le vrai sujet, c’est l’apprentissage en situation
Dans beaucoup d’organisations, on continue de récompenser les gens comme on récompense encore certains modèles : sur leur capacité à restituer correctement un cadre déjà stabilisé.
On valorise :
la réponse rapide,
la conformité élégante,
le vocabulaire rassurant,
la maîtrise du terrain connu.
On sous-valorise :
l’exploration,
le tâtonnement,
la reformulation du problème,
la capacité à apprendre avant de conclure.
Pourtant, la prochaine décennie favorisera moins les champions de la récitation que les professionnels capables de bouger avant le mode d’emploi, de tester sans certitude complète, d’observer ce qui se passe, puis de corriger vite.
C’est exactement ce que ce benchmark vient gifler.
ARC-AGI-3 ne dit pas que les IA sont inutiles.
Il dit quelque chose de bien plus intéressant :
elles sont extraordinaires dans certains cadres,
et encore très fragiles dans l’inconnu interactif.
Cette nuance est capitale.
L’illusion la plus coûteuse : confondre aisance verbale et intelligence générale
Le danger n’est pas que l’IA progresse.
Le danger est de mal lire la nature de ses progrès.
Quand un modèle parle avec assurance, l’humain projette très vite du sens, de la cohérence, de l’intention, parfois même une profondeur qu’il n’y a pas encore. Cette projection n’est pas nouvelle. Elle accompagne toute technologie spectaculaire. La différence, avec l’IA générative, c’est que la machine parle notre langue avec un talent suffisamment bon pour tromper notre intuition sociale.
Elle sonne juste.
Donc on lui prête de la justesse.
Elle semble structurée.
Donc on lui prête une stratégie.
Elle réussit un test.
Donc on lui prête une compréhension générale.
ARC-AGI-3 rappelle que la façade linguistique et la capacité d’adaptation n’évoluent pas forcément au même rythme.
Et pour les dirigeants, ce rappel vaut de l’or.
Ce que cela change pour le management
Dans mon livre, chapitre 14, j’explique que l’adoption de l’IA doit être traitée comme une innovation de procédé, avec une vision claire, une stratégie, des expérimentations et une communication solide, pas comme une ruée désordonnée vers l’outil du moment
ARC-AGI-3 renforce cette idée.
L’entreprise qui gagnera avec l’IA ne sera pas celle qui affichera le plus de démos.
Ce sera celle qui saura distinguer quatre choses :
1. Ce que l’IA sait très bien faire
Synthétiser, reformuler, assister, accélérer, structurer, produire des variantes, aider à analyser certains volumes d’information.
2. Ce qu’elle fait encore mal dans l’inédit
Explorer un environnement opaque, apprendre en situation avec peu d’indices, comprendre un but non dit, construire seule la bonne représentation d’un monde nouveau.
3. Ce que l’humain doit muscler
Le jugement, la décision, la mise en contexte, l’expérimentation, la détection du faux positif, l’apprentissage rapide.
4. Ce que l’organisation doit cesser de confondre
La productivité avec la compréhension.
La fluidité avec la profondeur.
Le benchmark avec la réalité.
La démo avec la robustesse.
Le futur appartient aux apprenants rapides
La leçon la plus utile n’est donc pas technologique. Elle est humaine.
Le futur n’appartient pas à ceux qui savent le mieux réciter le passé.
Il appartient à ceux qui savent apprendre plus vite que le décor ne change.
C’est vrai pour les individus.
C’est vrai pour les équipes.
C’est vrai pour les entreprises.
Et c’est aussi vrai pour les systèmes d’IA eux-mêmes.
La beauté du moment actuel, c’est que le vernis commence à craquer au bon endroit.
Nous sortons doucement de l’époque où parler comme un expert suffisait à être pris pour un expert.
Nous entrons dans une période où il faudra démontrer une autre qualité :
la capacité à comprendre quand le terrain cesse d’obéir aux règles d’hier.
L’IA peut réussir le barreau.
Très bien.
Mais quand elle entre dans une pièce sans consigne, face à un environnement qu’elle ne reconnaît pas encore, elle découvre soudain quelque chose que beaucoup d’entreprises évitent elles aussi depuis longtemps :
apprendre vraiment est plus difficile que répondre brillamment.
Et c’est précisément pour cela que les organisations les plus fortes demain seront celles qui recruteront, formeront et promouvront moins les champions du vernis que les champions de l’apprentissage en situation.
Le reste fera de très belles démonstrations.
Puis prendra le mur.
Références
(OpenAI) = https://openai.com/index/gpt-4-research/
(OpenAI PDF) = https://cdn.openai.com/papers/gpt-4.pdf
(ARC Prize Launch) = https://arcprize.org/blog/arc-agi-3-launch
(ARC Prize) = https://arcprize.org/arc-agi/3/
(ARC Prize Leaderboard) = https://arcprize.org/leaderboard
(arXiv) = https://arxiv.org/abs/2603.24621
(Revolution in AI) = https://www.revolutioninai.com/2026/03/arc-agi-3-benchmark-ai-scores-openai-spud-anthropic-2026.html
(Scaling01) = https://x.com/scaling01/status/2036853669065306534
(ARC Task LS20) = https://arcprize.org/tasks/ls20